如何从截图提取可编辑文字,而不生成视频?
将截图保存为 JPG、PNG 或 WebP,打开“提取文字”,选择文字语言后上传。检查结果,再下载 TXT 或 JSON。图片没有音频时间轴,因此不提供 SRT 导出。
来源与方法
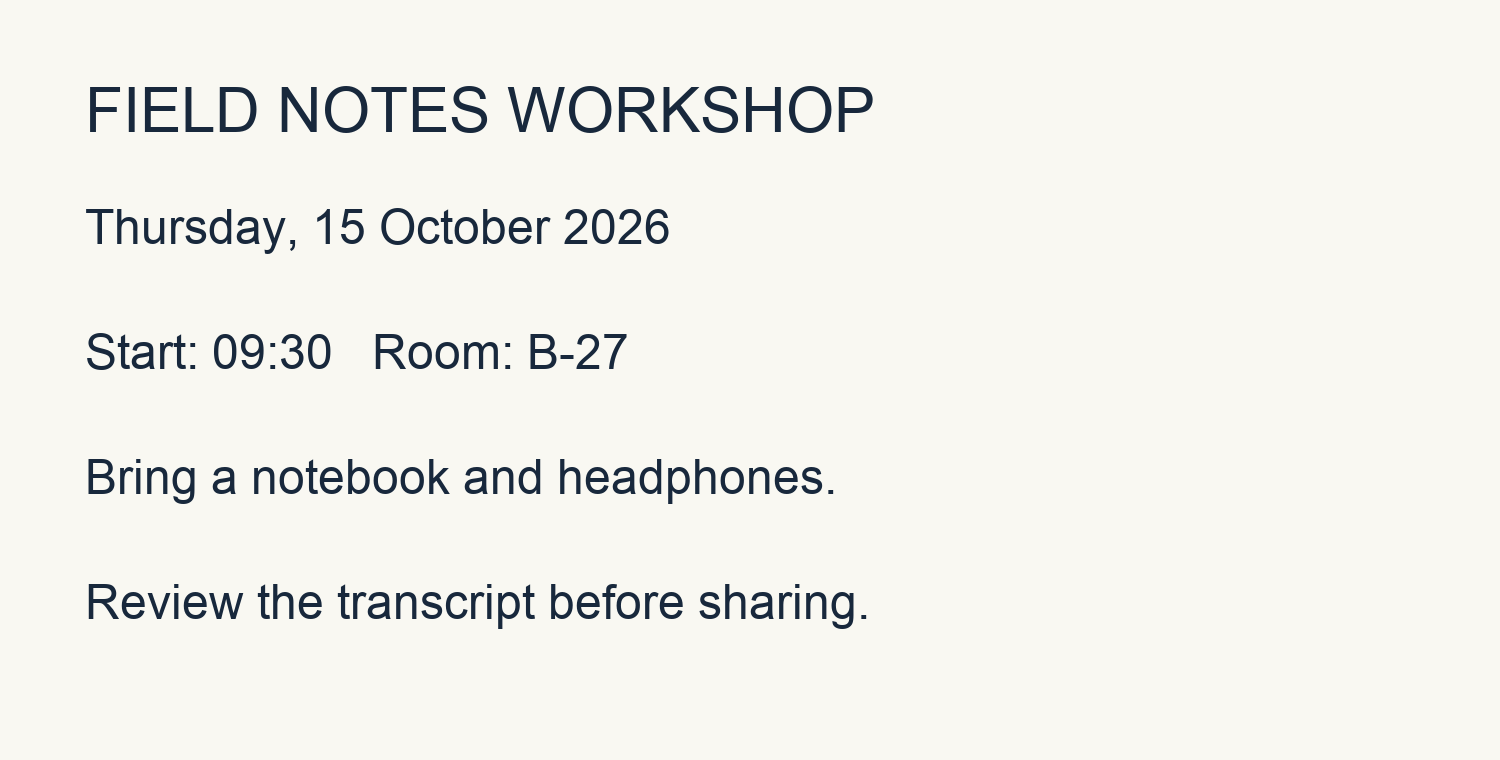
测试图片是专门绘制的原创英文活动通知。OCR 在 Linux 部署镜像内运行,使用网站相同的 Tesseract 识别代码。图片不来自用户,也不包含个人信息。
案例使用原创文稿、合成语音、自制音调和绘制的通知图片,不包含用户上传内容。切换界面语言时,源素材和识别文本保留原语言。
对比原文、识别结果和校对结果
原始文字
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30   Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
原始识别结果
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30 Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
校对结果
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30   Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
校对文本还原了预期文字及行顺序。请重点对比原始 OCR 的时间、房间号和标点。OCR 输出文字,不会重建原图的排版。
发布前需要检查什么
本次识别保留了所有预期文字、时间 09:30 和房间号 B-27,但将 Room 前的多个空格合并为一个。此清晰合成样本未测试手写字、艺术字体、复杂表格或低分辨率照片。
耗时与适用限制
耗时来自单次制作,不是服务速度承诺。音频案例在开发电脑上测量,图片 OCR 在 Linux 部署镜像中测量;不包含上传时间和共享队列的等待时间。
- 识别耗时
- 2.07 s
- 处理引擎
- tesseract 5.5.0
本案例用于展示产品流程,不是准确率基准测试,也不是用户评价。
产品信息
AI Free Audio to Video · audiosubvideo.com
- 价格及账户
- 免费使用,无需付费或注册;共享队列和每小时使用限制适用。
- 语音和图像识别
- 生产服务器使用 Whisper small 识别语音、Tesseract 识别图片文字。不支持说话人识别、转写翻译或人声分离。
- 下载
- MP4 视频; TXT、JSON 和 SRT 用于定时转录;用于图像 OCR 的 TXT 和 JSON。
- 谁可以访问结果
- 上传时使用的浏览器会话和已登录的网站管理员可以访问结果。用户上传内容不会作为公开案例。
- 音视频限制
- 100 MB · 10 min
- 完成后文件保留时间
- 24 小时