Wie extrahiere ich bearbeitbaren Text aus einem Screenshot, ohne ein Video zu erstellen?
Speichern Sie den Screenshot als JPG, PNG oder WebP, öffnen Sie Text extrahieren, wählen Sie die Textsprache aus und laden Sie ihn hoch. Überprüfen Sie das Ergebnis und laden Sie dann TXT oder JSON herunter. Ein Bild hat keine Audio-Timeline, daher ist der SRT-Export nicht anwendbar.
Quelle und Methode
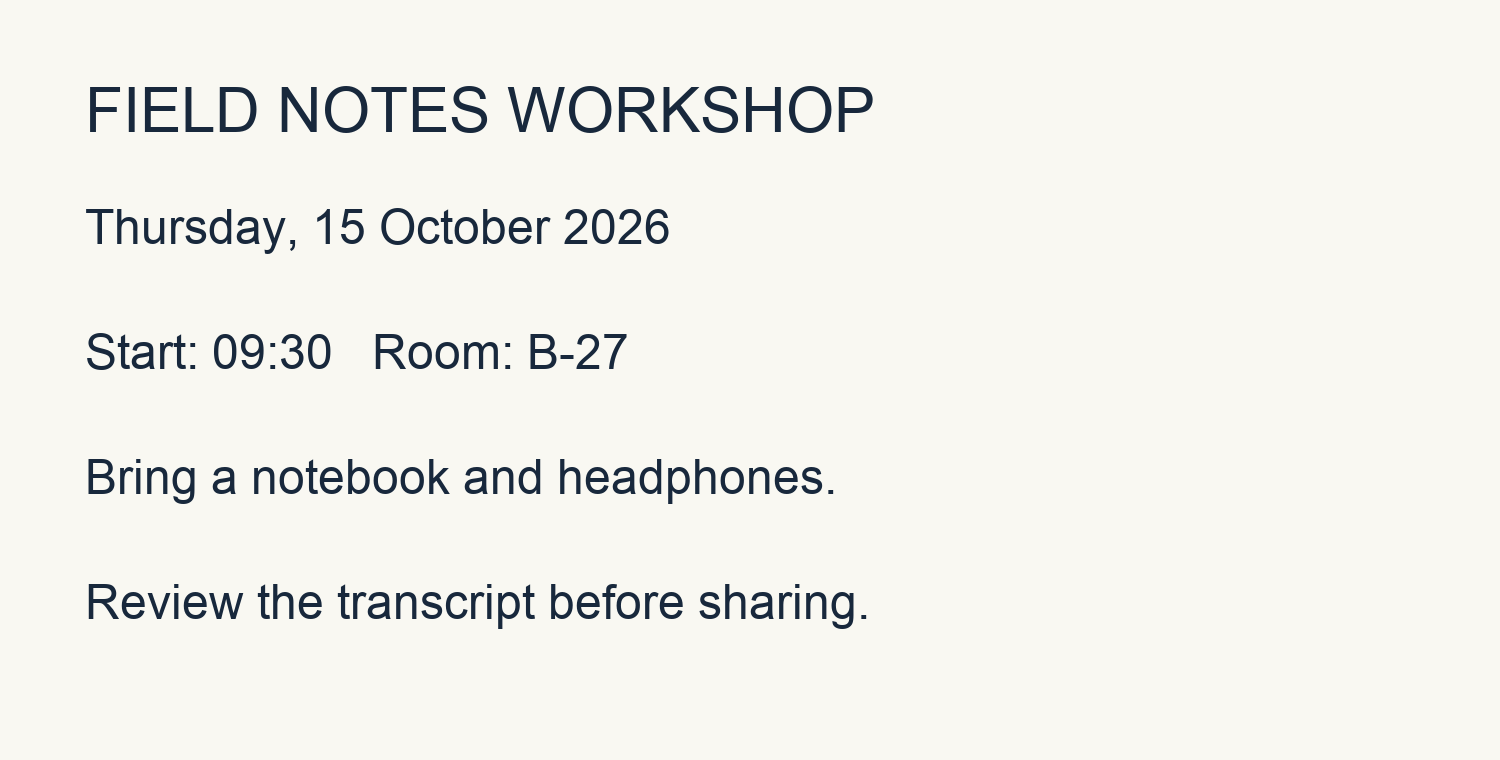
Das Bild ist eine originale englische Werkstattmitteilung, die für diesen Test erstellt wurde. OCR wird mit Tesseract innerhalb des Linux-Bereitstellungsimages unter Verwendung des Website-OCR-Codes ausgeführt. Es handelt sich nicht um einen Kunden-Screenshot oder ein Dokument mit persönlichen Informationen.
Diese Fallstudien verwenden Originalskripte, synthetische Sprache, generierte Töne und ein generiertes Hinweisbild. Sie enthalten keine Benutzer-Uploads. Quellmedien und erkannter Text behalten ihre Originalsprache, wenn sich die Sprache der Benutzeroberfläche ändert.
Originaleingabe herunterladen ↓ · Laden Sie die Einstellungen herunter ↓ · Quelltext herunterladen ↓
Vergleichen Sie Quelle, Anerkennung und Rezension
Quelltext
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30   Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
Unbearbeitetes Erkennungsergebnis
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30 Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
Überprüftes Ergebnis
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30   Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
Der überprüfte Text gibt die beabsichtigten Wörter und die Zeilenreihenfolge wieder. Vergleichen Sie es mit der OCR-Rohausgabe, insbesondere mit Uhrzeit, Raumnummer und Zeichensetzung. OCR gibt Text zurück, anstatt das Bildlayout zu rekonstruieren.
Was Sie vor dem Teilen überprüfen sollten
Bei diesem Durchlauf blieben alle beabsichtigten Wörter, die Zeit 09:30 und Raum B-27 erhalten, aber die zusätzlichen Leerzeichen vor Room wurden auf ein einziges Leerzeichen reduziert. Bei diesem klaren, synthetischen Hinweis werden Handschrift, dekorativer Typ, komplexe Tabellen oder Fotografie mit niedriger Auflösung nicht geprüft.
Messung und Einschränkungen
Die Zeiten beschreiben einen einzelnen Build-Lauf, kein Service-Level-Versprechen. Audiogehäuse werden auf dem Baucomputer gemessen; Die Bild-OCR wird im Linux-Bereitstellungsbild gemessen. Upload-Zeit und die gemeinsame Verarbeitungswarteschlange sind ausgeschlossen.
- Erkennungszeit
- 2.07 s
- Verarbeitungsmaschine
- tesseract 5.5.0
Dies ist eine Produktdemonstration, kein Genauigkeitsmaßstab oder Kundenbericht.
Probieren Sie diesen Workflow aus ↗
Produktfakten
AI Free Audio to Video · audiosubvideo.com
- Preis und Rechnung
- Kostenlose Nutzung ohne Bezahlung oder Anmeldung; Es gelten gemeinsame Warteschlangen und stündliche Nutzungsbeschränkungen.
- Sprach- und Bilderkennung
- Whisper small für Sprache und Tesseract für Bilder auf dem Produktionsserver. Keine Sprecheridentifikation, Transkriptübersetzung oder Stimmtrennung.
- Downloads
- MP4 für Videos; TXT, JSON und SRT für zeitgesteuerte Transkripte; TXT und JSON für Bild-OCR.
- Wer kann auf Ergebnisse zugreifen?
- Die ursprüngliche Browsersitzung und angemeldete Site-Administratoren. Bei den hochgeladenen Inhalten handelt es sich nicht um eine öffentliche Fallstudie.
- Audio- und Videobeschränkungen
- 100 MB · 10 min
- Dateiaufbewahrung abgeschlossen
- 24 Stunden