Comment extraire le texte modifiable d’une capture d’écran sans créer de vidéo ?
Enregistrez la capture d'écran au format JPG, PNG ou WebP, ouvrez Extraire le texte, sélectionnez la langue du texte et téléchargez-la. Examinez le résultat, puis téléchargez TXT ou JSON. Une image n’a pas de chronologie audio, donc l’exportation SRT ne s’applique pas.
Origine et méthode
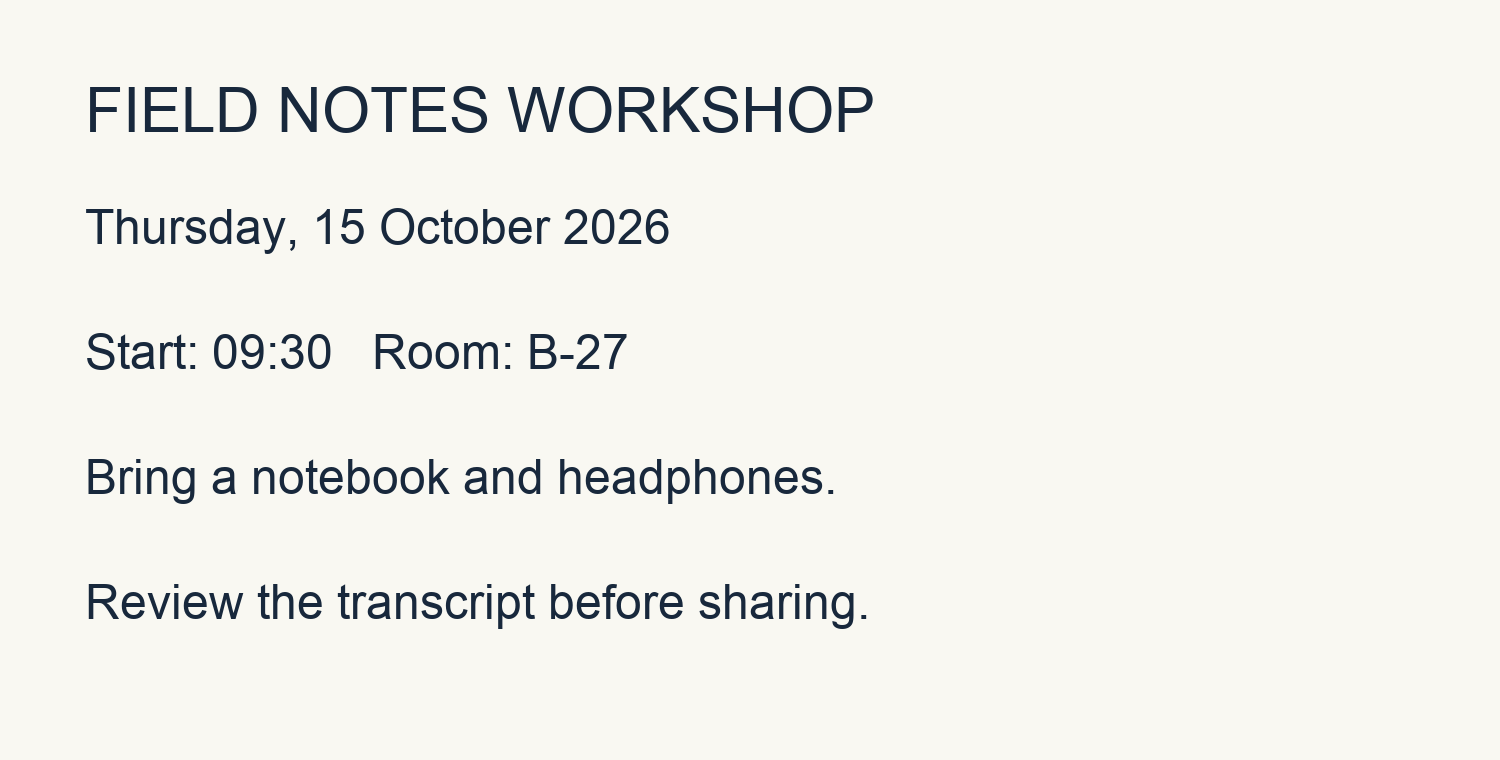
L'image est une notice d'atelier originale en anglais dessinée pour ce test. L'OCR est exécuté avec Tesseract dans l'image de déploiement Linux à l'aide du code OCR du site Web. Il ne s'agit pas d'une capture d'écran client ou d'un document contenant des informations personnelles.
Ces études de cas utilisent des scripts originaux, un discours synthétique, des tonalités générées et une image de notification générée. Ils ne contiennent aucun téléchargement d'utilisateur. Les médias sources et le texte reconnu conservent leur langue d'origine lorsque la langue de l'interface change.
Télécharger la contribution originale ↓ · Paramètres de téléchargement ↓ · Télécharger le texte source ↓
Comparez la source, la reconnaissance et l'examen
Texte source
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30   Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
Résultat de reconnaissance non édité
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30 Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
Résultat révisé
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30   Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
Le texte révisé reproduit les mots et l’ordre des lignes prévus. Comparez-le avec la sortie OCR brute, en particulier l'heure, le numéro de pièce et la ponctuation. L'OCR renvoie le texte plutôt que de reconstruire la mise en page de l'image.
Que vérifier avant de partager
Cette exécution a conservé tous les mots prévus, l'heure 09h30 et la salle B-27, mais a réduit les espaces supplémentaires avant Room à un seul espace. Cet avis synthétique clair ne teste pas l’écriture manuscrite, les caractères décoratifs, les tableaux complexes ou la photographie à basse résolution.
Mesure et limites
Les temps décrivent une seule exécution de build, et non une promesse de niveau de service. Les cas audio sont mesurés sur l'ordinateur de construction ; L'OCR de l'image est mesurée dans l'image de déploiement Linux. Le temps de téléchargement et la file d'attente de traitement partagée sont exclus.
- Temps de reconnaissance
- 2.07 s
- Moteur de traitement
- tesseract 5.5.0
Il s'agit d'une démonstration de produit, et non d'un test de précision ou d'un témoignage client.
Faits sur le produit
AI Free Audio to Video · audiosubvideo.com
- Prix et compte
- Utilisation gratuite sans paiement ni inscription ; des limites de file d'attente partagée et d'utilisation horaire s'appliquent.
- Reconnaissance vocale et d'image
- Whisper small pour la parole et Tesseract pour les images sur le serveur de production. Aucune identification du locuteur, traduction de transcription ou séparation vocale.
- Téléchargements
- MP4 pour les vidéos ; TXT, JSON et SRT pour les transcriptions chronométrées ; TXT et JSON pour l'OCR des images.
- Qui peut accéder aux résultats
- La session de navigateur d'origine et les administrateurs du site connectés. Le contenu téléchargé n’est pas une étude de cas publique.
- Limites audio et vidéo
- 100 MB · 10 min
- Conservation des fichiers terminée
- 24 heures