ビデオを作成せずにスクリーンショットから編集可能なテキストを抽出するにはどうすればよいですか?
スクリーンショットを JPG、PNG、または WebP として保存し、テキストの抽出を開き、テキスト言語を選択してアップロードします。結果を確認して、TXT または JSON をダウンロードします。画像にはオーディオ タイムラインがないため、SRT エクスポートは適用されません。
ソースと方法
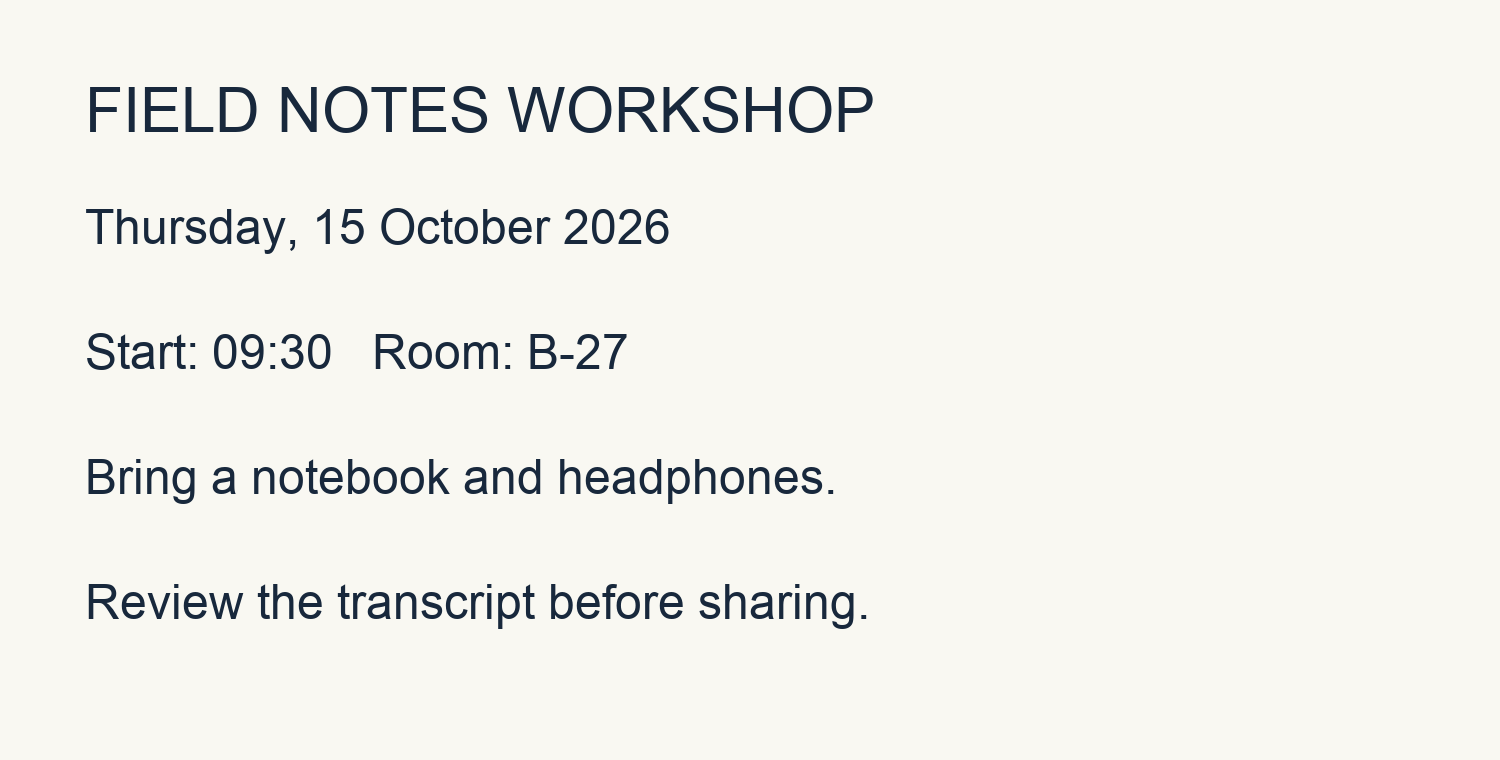
画像は、このテストのために描かれたオリジナルの英語ワークショップのお知らせです。 OCR は、Web サイトの OCR コードを使用して、Linux デプロイメント イメージ内の Tesseract で実行されます。これは顧客のスクリーンショットや個人情報を含む文書ではありません。
これらの事例では、オリジナルのスクリプト、合成音声、生成されたトーン、および生成された通知画像が使用されます。ユーザーによるアップロードは含まれていません。インターフェイス言語が変わっても、ソース メディアと認識されたテキストは元の言語を維持します。
ソース、認識、レビューを比較する
ソーステキスト
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30   Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
編集されていない認識結果
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30 Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
検討結果
FIELD NOTES WORKSHOP
Thursday, 15 October 2026
Start: 09:30   Room: B-27
Bring a notebook and headphones.
Review the transcript before sharing.
レビューされたテキストは、意図した単語と行順を再現します。これを生の OCR 出力、特に時刻、部屋番号、句読点と比較します。 OCR は、画像レイアウトを再構築するのではなく、テキストを返します。
共有する前に確認すべきこと
この実行では、意図した単語、時刻 09:30、部屋 B-27 がすべて保存されましたが、Room の前の余分なスペースが 1 つのスペースに減りました。この明確な合成通知は、手書き、装飾的なタイプ、複雑な表、または低解像度の写真をテストしません。
測定と制限
時間は、サービス レベルの約束ではなく、単一のビルド実行について説明します。オーディオのケースはビルド コンピューターで測定されます。イメージ OCR は、Linux デプロイメント イメージで測定されます。アップロード時間と共有処理キューは除きます。
- 認識時間
- 2.07 s
- 処理エンジン
- tesseract 5.5.0
これは製品のデモンストレーションであり、精度のベンチマークやお客様の声ではありません。
製品の事実
AI Free Audio to Video · audiosubvideo.com
- 価格とアカウント
- 支払いやサインアップなしで無料で使用できます。共有キューと時間ごとの使用制限が適用されます。
- 音声認識と画像認識
- 運用サーバー上の音声の場合は Whisper small、画像の場合は Tesseract。話者の識別、トランスクリプトの翻訳、または音声の分離はありません。
- ダウンロード
- ビデオの場合は MP4。時間指定トランスクリプトの TXT、JSON、および SRT。画像 OCR 用の TXT と JSON。
- 結果にアクセスできる人
- 元のブラウザー セッションとサインインしたサイト管理者。アップロードされたコンテンツは公開事例ではありません。
- オーディオとビデオの制限
- 100 MB · 10 min
- 完了したファイルの保存
- 24 時間